
keyword Quantization ที่นิยมเจอบ่อย: Q4_K_M, MLX, NVFP4 อันนี้ดีของ nvidia บีบอัดได้เยอะ แต่แทบไม่เสีย
Quantization คืออะไร? ทำไม AI บนคอมธรรมดาถึงไปได้ 🔥
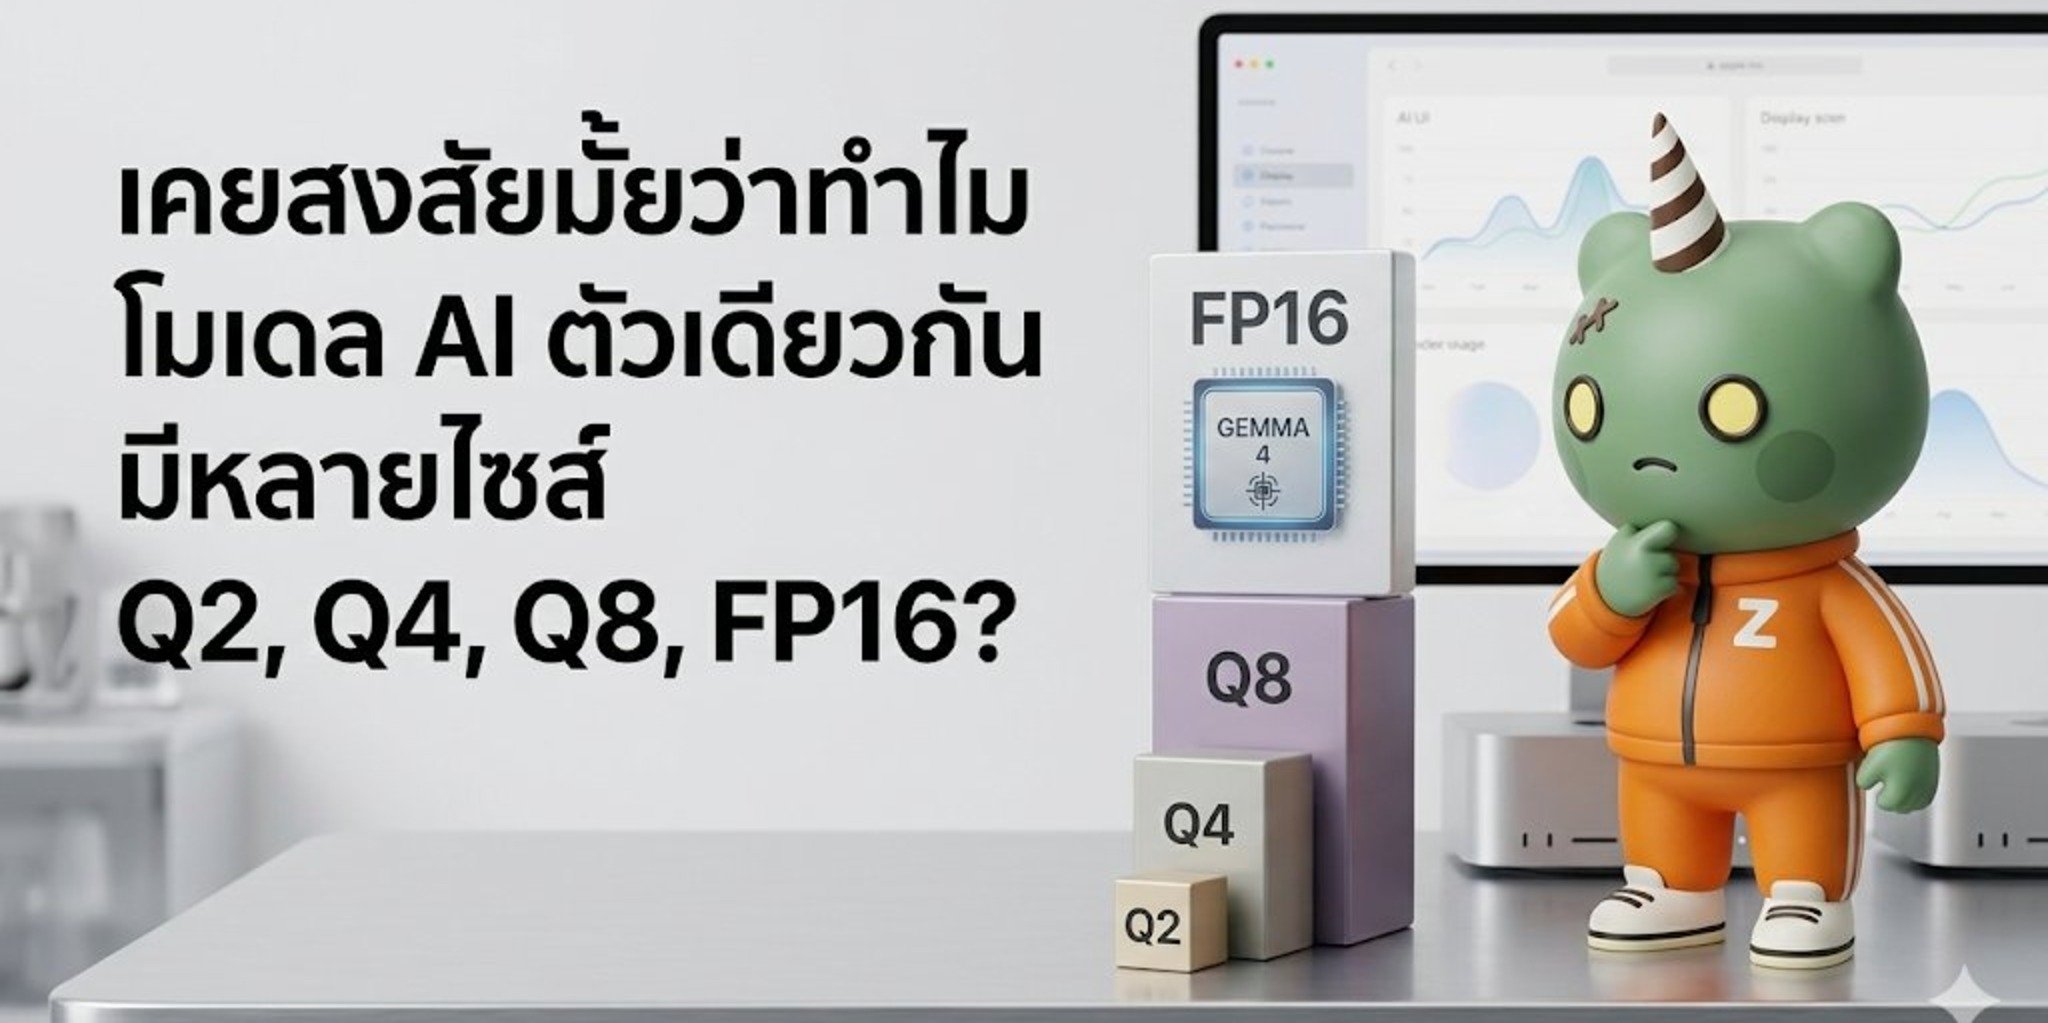
เคยสงสัยมั้ยว่าทำไมโมเดล AI ตัวเดียวกัน มีหลายไซส์ Q2, Q4, Q8, FP16?
ไฟล์เหมือนกัน แต่ขนาดต่างกัน 2-30 GB
คำตอบคือ Quantization — เหมือน MP3 ทำให้ AI 🎵
🎵 MP3 บีบอัดเพลง = เสียงแทบไม่ต่าง แต่ไฟล์เล็กลง 90%
🤖 Quantization บีบอัด AI = ความฉลาดแทบไม่ต่าง แต่ไฟล์เล็กลง 70%
ตัวเลขเหล่านี้คืออะไร?
• FP16 = ต้นฉบับ (16-bit) คุณภาพ 100%
• Q8 = เสียคุณภาพ <0.1%
• Q6 = เสียคุณภาพ ~0.3%
• Q4_K_M = เสียคุณภาพ ~1.5% คนส่วนใหญ่ใช้นี่
• Q3 = เสียคุณภาพ ~4%
• Q2 = เสียคุณภาพ ~10% (ควรหลีกเลี่ยง)
ทำไม Q4_K_M คือ default?
• 14B โมเดลจาก 28 GB → 8.4 GB (ลง 70%!)
• เสียคุณภาพแค่ 1.5% แทบจะไม่รู้สึก
• ใช้แรม 16 GB ก็รัน 14B ได้สบาย
Q2, Q3 ไม่คุ้มครับ — ประหยัดไฟล์นิดหน่อย แต่คุณภาพตกมาก
ค
วรเลือกอะไร?
• ใช้ทั่วไป → Q4_K_M
• เขียนโค้ด/คณิตศาสตร์ → Q5_K_M หรือ Q6
• แรมเยอะ (32GB+) → Q6_K หรือ Q8_0
สรุป: Q4_K_M = sweet spot ของการใช้ AI บนเครื่องธรรมดา
บทความนี้อธิบายแบบเต็มๆ ว่าทำไม quantization ถึงใช้งานได้ดีขนาดนี้ แนะนำให้อ่านครับ 👇